SeiKo – Das Seiteneinsteiger:innenkorpus
Blog-Beitrag von Aylin Braunewell
Das SeiKo-Team an der Justus-Liebig-Universität Gießen hat mit SeiKo, dem Seiteneinsteiger:innenkorpus, ein Korpus veröffentlicht, das die sprachliche Entwicklung neu zugewanderter Schüler:innen in sogenannten Intensiv- bzw. Vorbereitungsklassen dokumentiert. Das Korpus ist zugangsbeschränkt über ZENODO abrufbar.
Kontext und Forschungsinteresse
Das Seiteneinsteiger:innenkorpus (SeiKo, Schlauch et al. 2026b) ist Kern eines longitudinal angelegten Lerner:innenkorpusprojekts, das die sprachliche Entwicklung neu zugewanderter Schüler:innen in sogenannten Intensiv- bzw. Vorbereitungsklassen untersucht. Diese Seiteneinsteiger:innen stellen eine ausgesprochen heterogene Lerngruppe dar, etwa in Bezug auf ihre sprachlichen Repertoires, ihr Alter, ihre bisherigen Bildungsbiografien und die organisatorische Ausgestaltung ihrer Beschulung. Gemeinsam ist ihnen, dass sie im schulpflichtigen Alter mit für den Regelunterricht noch unzureichenden Deutschkenntnissen nach Deutschland kommen (vgl. Massumi/von Dewitz 2015).
In den meisten Bundesländern besuchen diese Schüler:innen zunächst Intensiv- oder Vorbereitungsklassen, die als Übergangsphase konzipiert sind. Ziel ist es, durch gezielte sprachliche Förderung eine möglichst erfolgreiche Integration in den Regelunterricht zu ermöglichen. Gerade diese frühe Phase des schulischen Zweitspracherwerbs ist jedoch bislang nur unzureichend empirisch untersucht, insbesondere im Hinblick auf die Entwicklung bildungssprachlicher und schriftsprachlich relevanter Kompetenzen (vgl. Twente/Marx 2026).
SeiKo setzt hier an und verfolgt das Ziel, die sprachliche Entwicklung von Schüler:innen in Intensivklassen systematisch und engmaschig zu erfassen. Im Fokus stehen dabei zwei zentrale Bereiche: zum einen die Entwicklung der Verbstellung als Indikator basalen syntaktischen Zweitspracherwerbs, zum anderen die Attribution von Nominalgruppen als Merkmal ausgebauter, stärker distanzsprachlich geprägter Varietäten. Von besonderem Interesse ist das Zusammenspiel dieser beiden Ebenen und ihre Entwicklung im Zeitverlauf sowie über verschiedene Modalitäten hinweg (vgl. @braunewellangenommena).
Im Folgenden wird vor allem die Nutzung von EXMARaLDA in der Aufbereitung der Korpusdaten beschrieben. Weiterführende Informationen zum Korpus, etwa zur Annotation oder zur Qualitätssicherung, entnehmen Sie bitte dem Korpus-Handbuch.
Korpusdesign, Workflow und Einsatz von EXMARaLDA
Die Datenerhebung erfolgte in Form ca. monatlicher Erhebungen an Schulen. Pro Erhebung und Schüler:in wird jeweils eine Audiodatei aufgenommen. Die Schüler:innen erzählen in Rotation eine von sechs eigens entwickelten Bildergeschichten nach. Dabei werden in jeder Erhebung durch unterschiedliche, aufeinander aufbauende Aufgaben schrittweise stärker distanzsprachliche Mittel elizitiert:
Zunächst erfolgt eine mündliche Nacherzählung für die anwesende Interviewperson mit anschließenden verständnissichernden Fragen. Danach diktieren die Schüler:innen dieselbe Geschichte für eine nicht anwesende Adressatin. Anschließend wird die Geschichte selbstständig verschriftlicht.
Die Audiodateien wurden anschließend in EXMARaLDA geladen und, separiert nach Aufgabenabschnitt, in einzelnen Dateien transkribiert. Die Transkription erfolgte nach an HIAT orientierten Konventionen, die es erlauben, auch Unklarheiten sichtbar zu machen. Zusätzlich wurde eine Kommentarsprache genutzt, in der Transkribend:innen Hinweise zu Zweifelsfällen oder zur Anonymisierung hinterlassen konnten.
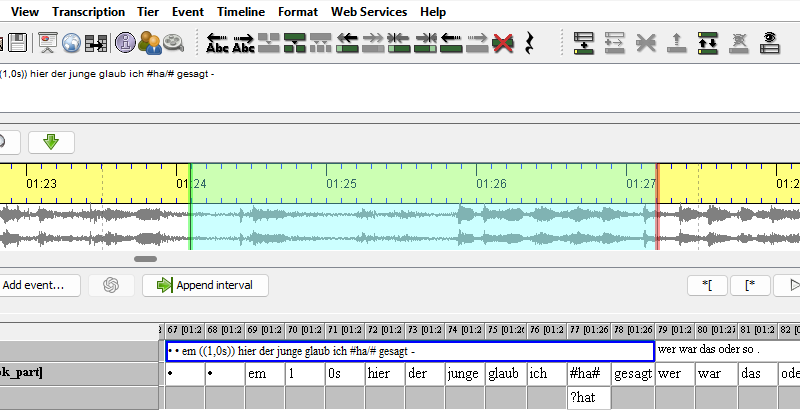
Im nächsten Schritt wurden die Transkripte in EXMARaLDA automatisch tokenisiert. An Problemstellen – insbesondere bei überlappender Rede – wurde die Tokenisierung manuell nachbearbeitet. Das Ergebnis dieses Arbeitsschritts ist in Abbildung 1 dargestellt.
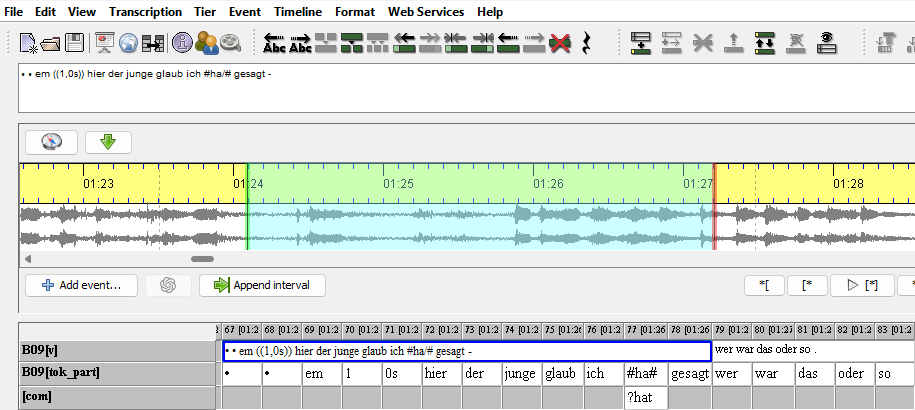
Darauf folgte ein Wechsel der Bearbeiter:innen und die Daten wurden manuell segmentiert, wobei auch eine Korrektur der Transkription vorgenommen wurde. Andere Projektmitarbeiter:innen als die Transkribend:innen prüften die Transkriptionen und entschieden über Zweifelsfälle. Die Segmentierung orientiert sich an der Analysis Of Speech Unit (Foster et al. 2000), wurde jedoch für die Zwecke von SeiKo weiterentwickelt (vgl. dazu Schlauch et al. 2026a).
Ziel war bei der Segmentierung, Äußerungseinheiten zu bilden, die sowohl ein zuverlässiges automatisches POS-Tagging und eine automatische Lemmatisierung ermöglichen als auch eine tragfähige Grundlage für die anschließende Annotation darstellen. Zweifelhaft erscheinende Segmentierungen konnten erneut kommentiert werden; zudem wurde konsequent nach dem Vier-Augen-Prinzip gearbeitet und Zweifelsfälle wurden besprochen. Ein beispielhaftes Ergebnis dieser Arbeitsschritte ist in Abbildung 2 zu sehen.
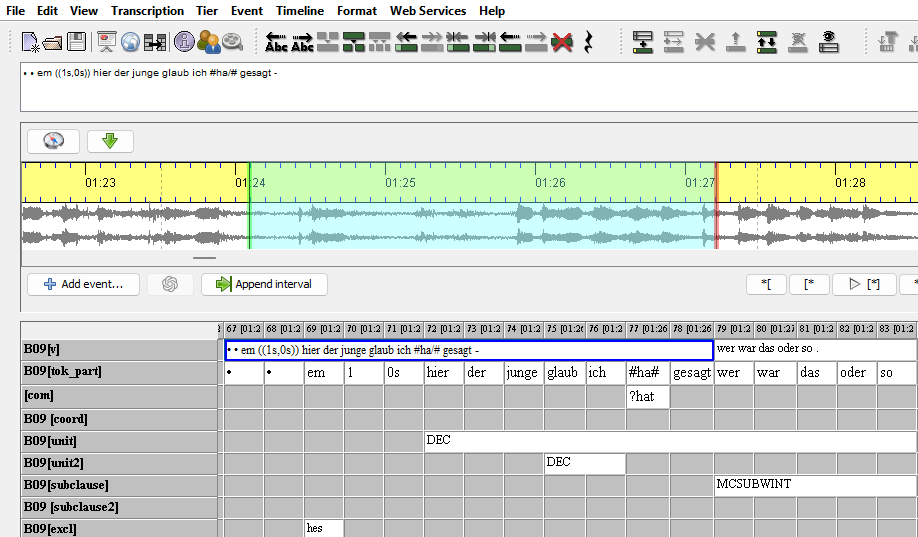
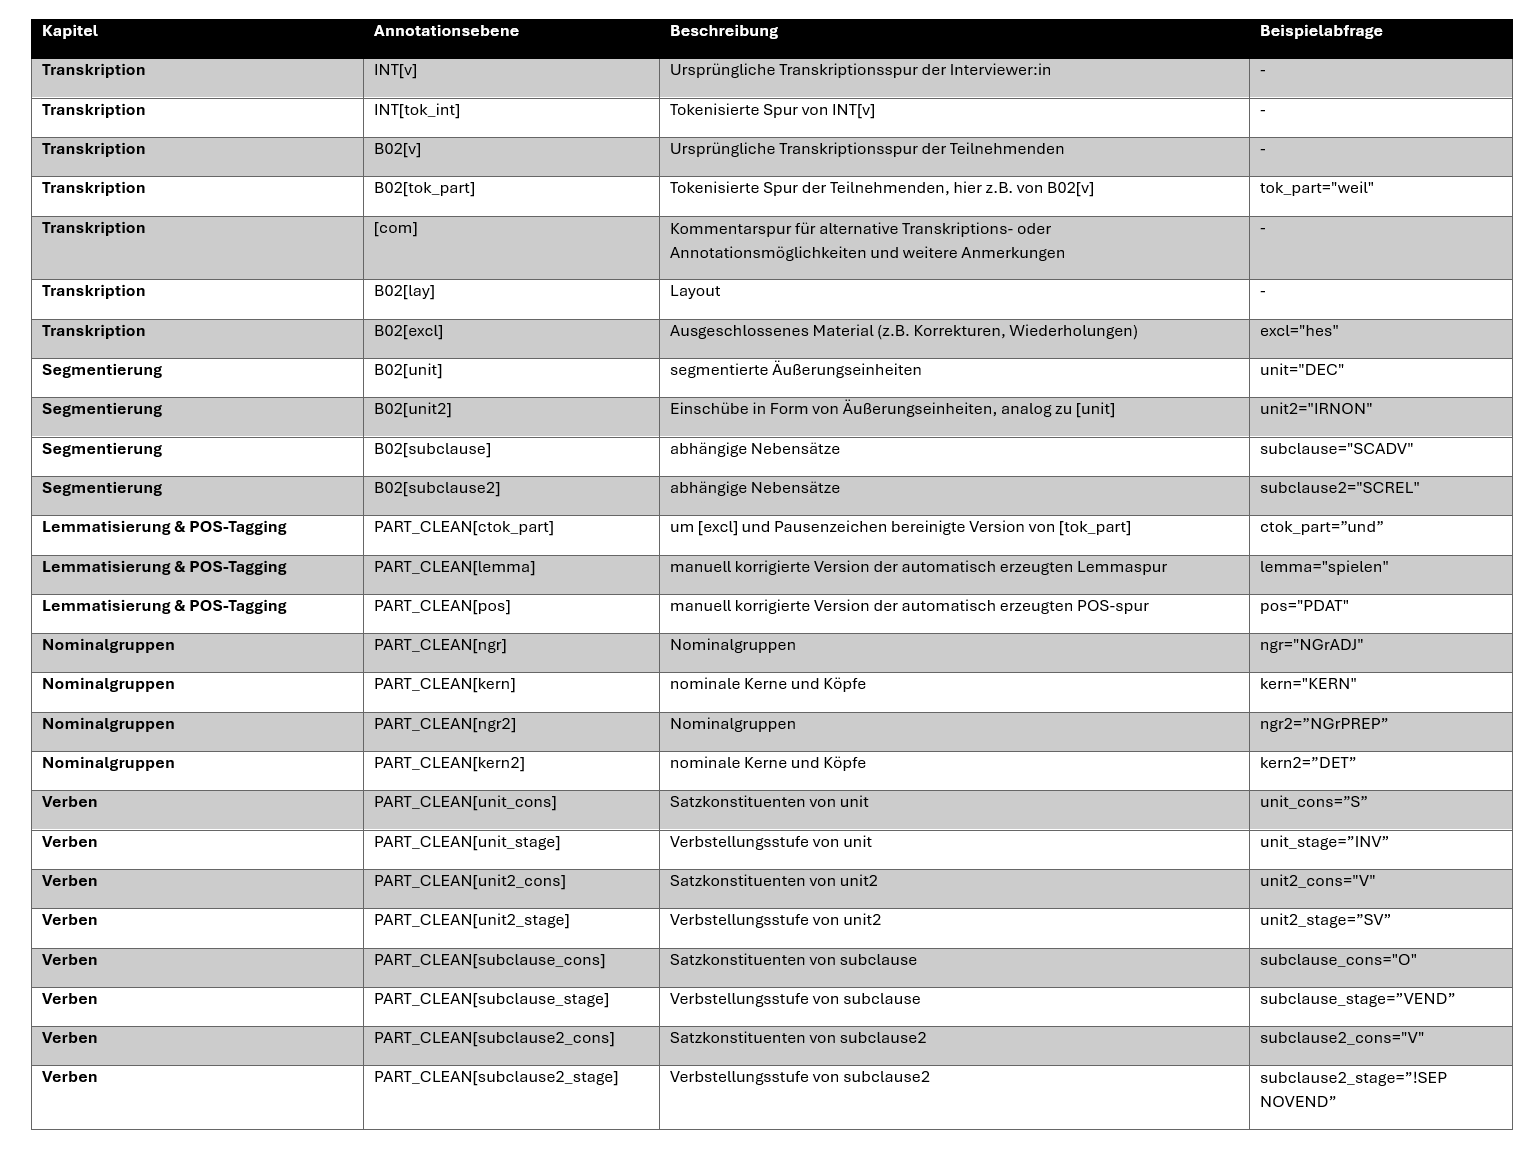
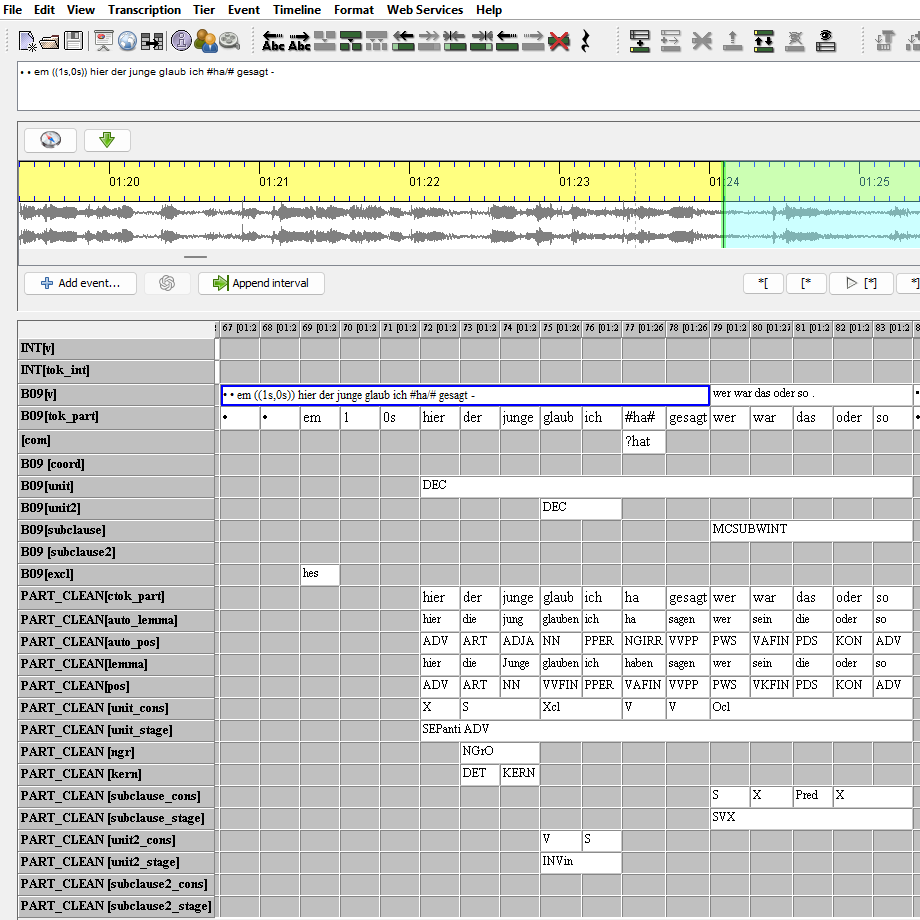
Im Anschluss erfolgten die automatische Lemmatisierung und das POS-Tagging mithilfe des Treetaggers (Schmid1 995). Eine Übersicht über die Annotationsebenen ist in Tabelle 1 dargestellt; eine Bildschirmaufnahme einer Beispieldatei mit möglichen Spuren zeigt Abbildung 3. Technisch bedingt wurde für die weitere Bearbeitung ein Sprecher PART_CLEAN erzeugt, dem die neuen Annotationsspuren zugeordnet wurden. Informationen zur Annotation finden sich in Schlauch et al. (2026a).
Abschließend wurden die Daten mithilfe einer Pipeline ANNIS-kompatibel aufbereitet. Das Korpus kann anschließend in ANNIS hochgeladen und dort abgefragt oder alternativ mit
ANNIMATE ausgewertet und die Ergebnisse exportiert werden. Die Versionierung der Dateien erfolgte über Gitlab.
Nutzung des Korpus
Das Korpus ist zugangsbeschränkt über ZENODO abrufbar. Außerdem ist eine Veröffentlichung des Korpus in der DAKODA-Infrastruktur geplant. Die Nutzungsbedingungen sind dem Korpushandbuch zu entnehmen.
Projektbeteiligte
Am Projekt waren beteiligt:
- Prof. Dr. Jana Gamper (Projektleitung)
- Julia Schlauch (Wissenschaftliche Mitarbeit, Korpuskonzeption, Datenerhebung, Datenaufbereitung, Qualitätssicherung, Dokumentation)
- Aylin Braunewell (Wissenschaftliche Mitarbeit, Datenaufbereitung, Qualitätssicherung, Dokumentation)
- Martin Klotz (Beratung zur technischen Datenaufbereitung und Qualitätssicherung)
- Anna Gäde (Transkription)
- Dominik Kainz (Datenerhebung und Transkription)
- Felix Luckau (Datenerhebung)
- Laura Meige (Transkription und Segmentierung)
- Anna Vogel (Datenerhebung und Transkription)
- Pauline Wardenski (Transkription und Segmentierung)
Literaturverzeichnis
- Braunewell, Aylin/Schlauch, Julia/Gamper, Jana (angenommen): Von Der Verbstellung Zur Erweiterten Nominalgruppe? Zum Verhältnis Zwischen Verbalen Und Nominalen Ausbaustrukturen Bei Neu Zugewanderten Schüler:Innen in Vorbereitungsklassen. In: Germanistische Linguistik.
- Foster, Pauline/Tonkyn, Alan/Wigglesworth, Gillian (2000): Measuring Spoken Language: A Unit for All Reasons. In: Applied Linguistics 21(3).
- Massumi, Mona/von Dewitz, Nora (2015): Neu Zugewanderte Kinder Und Jugendliche Im Deutschen Schulsystem. Mercator-Institut für Sprachförderung und Deutsch als Zweitsprache und Zentrum für LehrerInnenbildung der Universität zu Köln: o. V.
- Schlauch, Julia/Braunewell, Aylin/Gamper, Jana (2026a): SeiKo (Korpus Seiteneinsteiger: Innen in Vorbereitungsklassen): Handbuch Zu Korpusdesign Und Datenaufbereitung. Version 1.1. Zenodo. https://doi.org/10.5281/zenodo.21495943.
- Schlauch, Julia/Braunewell, Aylin/Gamper, Jana/Klotz, Martin (2026b): Ein Lernerkorpus Neu Zugewanderter Schüler:Innen (Seiteneinsteiger:Innen) in Vorbereitungsklassen. Zenodo. https://doi.org/10.5281/zenodo.21476830.
- Schmid, Helmut (1995): Improvements in Part-of-Speech Tagging with an Application to German. Proceedings of the ACL SIGDAT-Workshop. Dublin, Ireland.
- Twente, Leonie Regina/Marx, Nicole (2026): How Do We Research Language Skills and Repertoires of Newly Immigrated Students? A Scoping Review of Studies in German-Speaking Countries. In: Research Synthesis in Applied Linguistics 2(1), S. 176–220. https://doi.org/10. 1080/29984475.2026.2635486.